Você já tentou “conversar” com um banco de dados em português?
Uma pesquisa apresentada na PROPOR 2026 analisou o desempenho de grandes modelos de linguagem na conversão de perguntas em português para SQL. Os resultados mostram que ferramentas como Claude, Gemini, DeepSeek e Qwen apresentam queda de precisão em comparação ao inglês. O estudo também identificou que modelos com capacidade de raciocínio continuam processando informações internamente em inglês, o que pode gerar erros. A pesquisa destaca os desafios para tornar a inteligência artificial verdadeiramente multilíngue em aplicações técnicas e de análise de dados.
 Pro. Anderson Soares
· 2 min de leitura
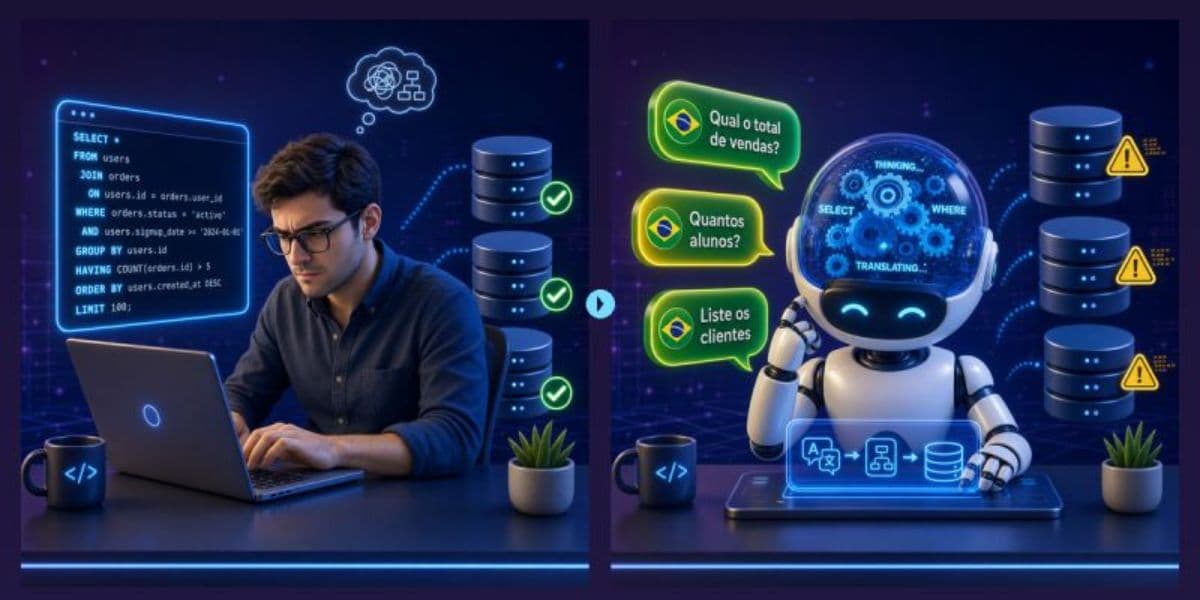
Os Grandes Modelos de Linguagem (LLMs) conseguem transformar perguntas feitas em linguagem natural em códigos SQL (a linguagem dos bancos de dados). Isso é incrível porque permite que qualquer pessoa, mesmo sem saber programar, consiga extrair informações valiosas de sistemas complexos.
Mas tem um detalhe: a maioria dessas IAs foi treinada focando no inglês. O que acontece quando pedimos para elas fazerem isso em português?
Nosso estudo recente testou várias IAs de ponta (como Claude, Gemini, DeepSeek e Qwen) nessa tarefa. Os principais achados foram surpreendentes:
1️⃣ Caiu o rendimento: Todas as IAs testadas tiveram uma queda de precisão quando a pergunta foi feita em português. Algumas caíram pouco (como o Gemini 2.5 Pro e o Claude 4.5 Sonnet), mas outras despencaram.
2️⃣ Pensando em inglês: Mesmo quando a pergunta e os dados estavam em português, as IAs que possuem “modo de raciocínio” (thinking mode) continuaram pensando internamente em inglês! Isso gera um ruído na tradução mental da máquina e causa erros.
3️⃣ Raciocinar não basta: Apenas ligar o “modo de raciocínio” da IA não resolveu o problema. O que realmente ajudou foi dar à IA um plano guiado (um passo a passo de como montar a consulta).
O que isso significa para nós? Ainda temos um longo caminho para tornar a IA verdadeiramente multilíngue em tarefas complexas e técnicas. Precisamos de mais pesquisas e adaptações focadas no nosso idioma para que as ferramentas de dados sejam acessíveis a todos os brasileiros, sem barreiras linguísticas!
🔗 Quer saber mais? O artigo completo “Language Effects in Text-to-SQL Across English and Portuguese” foi publicado por mim e meus colegas de pesquisa Lucas Nobre, Suele Sousa e Savio Teles no International Conference on Computational Processing of Portuguese (PROPOR 2026), o principal evento científico para o tema de processamento de linguagem natural para língua portuguesa.
Link nos comentários.

Fundador e Vice Presidente de Tecnologia do Centro de Excelência em Inteligência Artificial (CEIA)